La IA multiplicó lo que un equipo de contenido produce; nadie multiplicó la revisión. El cuello de botella pasó de crear a aprobar.
Este fin de semana participé en el Hackathon 30X y, en unas 48 horas, construí Gatekeeper Editorial 30X: un filtro editorial con IA que decide, en milisegundos, si cada pieza de contenido de una marca sale, se mejora con IA, la revisa una persona o se descarta. Y si no pasa, la IA la corrige sola y la vuelve a revisar.
Aquí cuento el problema, cómo funciona, los números y lo que salió mal en el camino.
El problema: el día de un editor #
Piensa en el editor de un equipo de contenido hoy:
- Revisa a mano, una por una, decenas de piezas: posts, guiones, clips, newsletters, capturas. Muchas ya hechas con IA.
- Cada persona aplica su propio criterio, hay retrabajo y siempre está el miedo a que algo riesgoso salga ante cientos de miles de seguidores.
¿Por qué no pasar todo por ChatGPT? Porque un modelo de lenguaje escribe texto que después hay que interpretar. No te da un “sí o no” consistente y medible para miles de piezas al día.
El reto y por qué elegí esta idea #
El hackathon tenía un reto llamado “Reto 30X: JEV”, con esta pregunta: ¿Qué decisiones de 30X podría tomar JEV miles de veces al día, en milisegundos, y cómo se ve eso funcionando?
- 30X es una escuela de negocios latinoamericana con mucho contenido en redes: unos 425 mil seguidores en Instagram.
- JEV es el modelo de decisión de TypeSafe. No escribe texto: decide. Responde preguntas con respuestas tipadas y probabilidades (elegir una opción, sí o no con probabilidad, o un puntaje), rápido y barato.
Antes de programar, investigué: leí el reto y la documentación de JEV, revisé la web, el Instagram y los programas de 30X, e hice una lista de ideas que cumplieran tres cosas: una decisión que se repite miles de veces al día, que se pueda medir y que escale.
Mi compañero de equipo, Haron Acosta, propuso varias ideas, entre ellas segmentar a los inscritos a eventos. Elegí empezar por el “gatekeeper” de contenido porque se entiende en 10 segundos en una demo, toca un dolor real de cualquier equipo de marketing y el mismo motor sirve después para otras decisiones.
El principio que guió todo el diseño:
JEV decide, el código calcula, la IA generativa solo escribe cuando hace falta y una persona revisa solo lo que importa.
En la práctica, eso significa que contar, sumar, comparar con umbrales y manejar fechas vive en código normal, nunca dentro de una pregunta a la IA. Y que los umbrales y las reglas editoriales son datos, no código: el equipo de Media los puede ajustar sin programar.
Cómo funciona #
¿Esta pieza sale? #
- Entra la pieza: texto o una captura de imagen. La sube alguien del equipo o la genera una IA.
- JEV responde 12 preguntas en una sola llamada, armadas con el perfil de la marca: tema y formato; relevancia, si es accionable y su alcance potencial; y una serie de sí o no con probabilidad (demasiado promocional, promesas exageradas, datos sin fuente, riesgo de marca, vende algo que la marca no vende, spam, encaje con la línea editorial). JEV también “lee” imágenes: juzga capturas, no solo texto.
- El código aplica la política y elige la ruta. Hay cuatro salidas:
- Aprobado: se publica sola. Necesita seguridad alta, ninguna alerta y buen puntaje editorial.
- Mejorar con IA: la zona gris.
- Revisar: riesgo o duda real; decide una persona.
- Descartado: spam o fuera de la marca.
- Si no pasa, la IA la corrige sola, sin que nadie haga clic. Un modelo de OpenAI reescribe el texto con la voz de la marca, corrigiendo solo lo que JEV marcó. Otro genera una imagen nueva, natural, con personas y ambientes reales y el titular en los colores de la marca.
- JEV vuelve a revisar la versión nueva. Si la aprueba, un clic en “Aprobar y guardar” y queda como versión 2, con su historial.
- Se publica desde un tablero tipo kanban (Por revisar, Por mejorar, Aprobado, Rechazado). En la demo la publicación es simulada; la integración real con las redes quedó para después.
Un detalle importante: si JEV no responde, la pieza nunca se aprueba sola. Cuando el sistema se equivoca, se equivoca del lado prudente.
El caso de las pastillas #
Esto pasó en producción el día de la entrega. Subí una captura de spam: “Pastillas para bajar 10 kilos en una semana, resultados garantizados”.
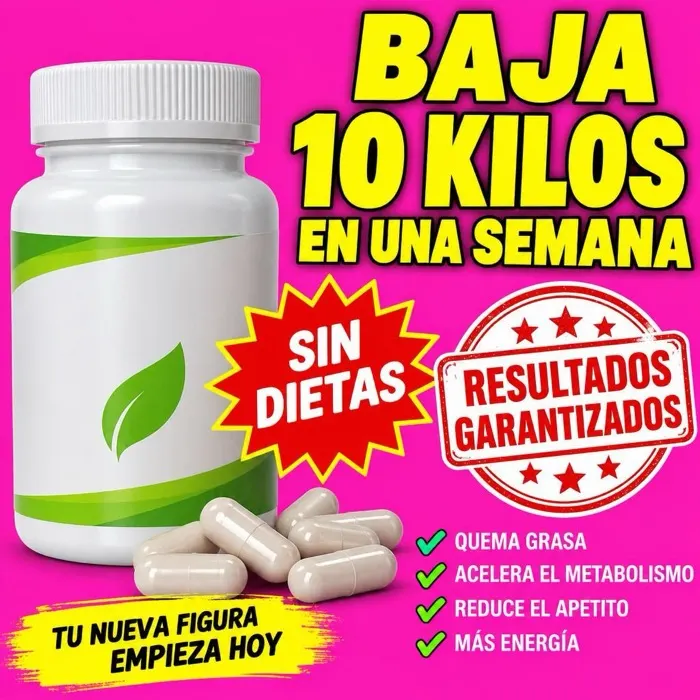
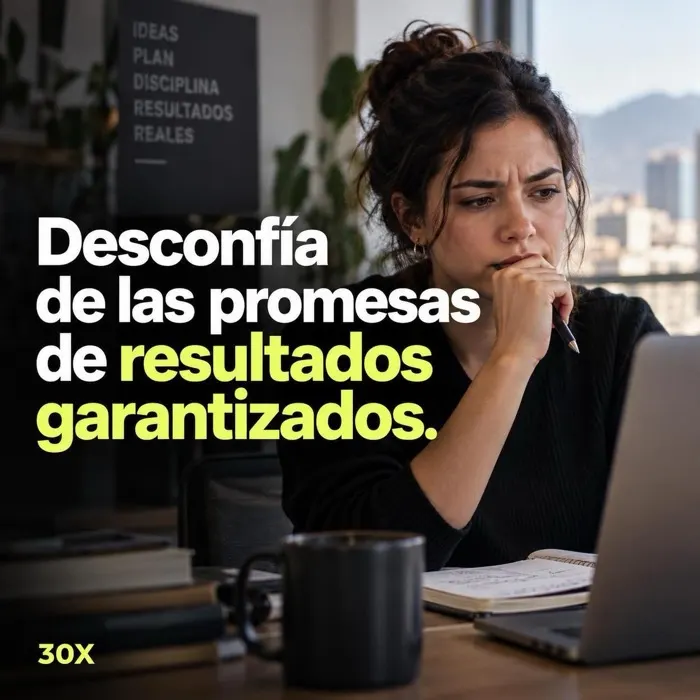
- JEV la descartó en menos de un segundo y dijo por qué: promesas exageradas, vende algo que 30X no vende y datos de salud sin fuente.
- La IA la convirtió sola en un post de 30X, “Desconfía de las promesas de resultados garantizados”, sobre tener criterio ante el marketing exagerado, con una foto nueva.
- JEV revisó la versión nueva y la aprobó.
La segunda decisión: ¿a qué programa va este inscrito? #
Era la idea número uno que propuso 30X: cada persona que se inscribe a sus eventos en Luma, ¿a qué programa va y la llamamos ya? Hoy también se decide a mano.
Es el mismo motor con otra decisión. JEV lee solo lo que la persona deja al inscribirse (rol, país, dolor, objetivo y temas), nunca las etiquetas internas de 30X, y en una pasada decide cinco cosas: el programa que le encaja (o “sin programa claro”), su cargo, su madurez en IA, si está lista para hablar con un asesor y si hay contexto suficiente para decidir. Después, el código elige la acción: pasarla a un asesor, enviarle la propuesta, nutrirla con clases gratis o mandarla a revisión humana.
Para cualquier marca #
En el onboarding pegas la web de tu marca y el sistema la lee: qué vende, a quién le habla, cómo habla y sus colores. Con eso se arman las preguntas que contesta JEV, incluido lo que esa marca nunca debe publicar. Cada cuenta tiene su perfil de marca, así que es multimarca desde el primer día.
Los números #
Escala #
Esta era la respuesta directa al reto. Corrí 1.000 decisiones reales contra JEV en producción, sin caché:
| Métrica | Resultado |
|---|---|
| Tiempo total | 4,5 segundos |
| Decisiones por segundo | 222 |
| Tiempo por decisión (p50) | 128 ms |
| Decisiones en menos de 250 ms | 95 % |
| Veces que hizo falta el respaldo de OpenAI | 0 |
A ese ritmo, 10.000 piezas de un día se revisan en menos de un minuto. El equipo nunca espera al filtro. La prueba se puede repetir en vivo desde la app, en Resultados.
Calidad en contenido #
Armé una base de prueba de 45 piezas simuladas y etiquetadas a mano, con lo que debería pasar con cada una:
| Métrica | Resultado |
|---|---|
| Acierto con la primera política | 53 % |
| Acierto después de calibrar | 80–87 %, según la corrida |
| Piezas resueltas sin que una persona las toque | 42 % |
| Piezas riesgosas o spam aprobadas solas | 0 |
| Tiempo por pieza, incluso con imagen | ~0,3 s |
En horas, eso son unas 3,5 horas recuperadas por cada 100 piezas, contando 5 minutos por revisión manual (un supuesto que se puede ajustar).
Segmentación de inscritos #
Sobre 200 de los 697 perfiles anónimos que compartió 30X:
| Métrica | Resultado |
|---|---|
| Coincidencia con el programa que sugiere 30X | 55,5 % |
| Coincidencia donde 30X sí sugirió un programa | 60 % |
| Coincidencia en AI Sales | 95 % |
| Precisión al marcar “listo para un asesor” | 88 % |
| Tiempo por persona | 93 ms |
Una lectura honesta del 55 %: es una primera iteración sobre perfiles muy escasos (el 73 % no declara su rol). Lo que ya sirve es que el asesor sabe a quién llamar primero.
Cómo lo construí #
Stack: Next.js 16 con React 19, TypeScript y Tailwind v4. JEV de TypeSafe a través de su SDK, con la API de decisiones de OpenAI como respaldo si JEV falla (en las mediciones se usó cero veces). Modelos de OpenAI para reescribir texto, extraer la marca de su web e imágenes. SQLite en un volumen persistente. Docker y Coolify en mi propio servidor, con despliegue automático en cada merge y DNS en Cloudflare. CI en GitHub Actions con lint, typecheck, tests y build.
Arquitectura: un módulo por área de negocio (revisión de contenido, marca, cuentas, workspace, segmentación), cada uno con su dominio puro, casos de uso, adaptadores y UI. Las rutas de la API son delgadas, toda llamada a JEV pasa por un solo cliente, los secretos quedan en el servidor, y las políticas Estricto, Equilibrado y Flexible son datos que el equipo cambia sin deploy.
Alrededor del motor, un CRM liviano: cuentas con solo email, una bandeja con lo que necesita una persona, el kanban con historial y versiones, carga de la grilla de contenido desde Excel o CSV con calendario de campaña, botones para copiar o descargar, la pantalla de Resultados y límites diarios de uso para que nadie abuse de las API keys de una demo pública. Lo de Excel salió de una sesión de feedback: los equipos siguen planificando ahí, así que el sistema se adapta a eso en vez de pedirles que cambien.
Cómo trabajé: usé agentes de IA de programación (Claude Code) como equipo. Varios trabajaban en paralelo, cada uno en su propia rama, mientras yo revisaba, decidía y hacía merge. Con Conventional Commits y PRs pequeños, fueron más de 40 PRs en el fin de semana, cada uno con el CI en verde antes de entrar, y después de cada merge desplegaba y verificaba en producción. Antes de grabar la demo, un agente ensayó el guion completo contra producción y encontró problemas reales que corregimos a tiempo.
Lo que salió mal #
- El sistema decía demasiado “aporta poco valor”. La pregunta medía solo si la pieza era un “cómo hacer”. La cambié para medir cualquier aporte: un dato, una historia, información de un evento o un siguiente paso claro.
- Los anuncios de eventos se marcaban como venta dura. Ajusté las preguntas: invitar a un evento o a una clase gratis no es vender, y los datos propios de la marca no son “datos sin fuente”.
- Las imágenes regeneradas salían planas y naranjas. Eran tarjetas de texto sin vida, y el color de marca por defecto estaba mal. Reescribí el prompt de imagen inspirándome en el feed real de 30X: fotos con personas y ambientes, titular en negrita con el lima de la marca.
- Al leer Instagram y LinkedIn, el sistema describía a Instagram y LinkedIn en vez de a la marca. Cuando el perfil estaba bloqueado, caía a la página principal de la red social. Lo arreglé detectando las redes sociales y leyendo solo su vista previa.
- Una versión aprobada por JEV cambiaba a “por mejorar” al guardarla. Al guardar se volvía a revisar y, como estaba justo en el límite de confianza, a veces cambiaba de ruta. Ahora se guarda con el mismo veredicto que la persona vio. Este error lo encontró el ensayo automático del guion, horas antes de la entrega.
- El healthcheck del despliegue fallaba porque
localhostresolvía a IPv6 dentro del contenedor. Se arregló usando127.0.0.1. - Una imagen de ejemplo generada por IA traía un personaje con derechos de autor. La regeneré y agregué al prompt la regla de no usar personajes, logos ni personas reales.
Decisiones de producto #
- Del dashboard técnico a una app para el equipo. El primer diseño mostraba latencias, probabilidades y costos. Lo simplifiqué a lo que el equipo necesita ver: qué sale, qué no y por qué. Y de muchas pestañas pasé a cinco secciones: Bandeja, Contenido, Crear, Inscritos y Resultados.
- Lo más rápido para la demo fue también lo mejor para el usuario. La corrección con IA arranca sola al subir una pieza, sin botón, y lo aprobado se publica con un clic.
- Dejamos de hablar de dinero y hablamos de personas. Un mentor nos dijo que el bajo costo de JEV es obvio y que había que enfocarse en cómo ayuda a los equipos. Pasamos de “cuesta centavos” a “tu equipo deja de aprobar a mano y vuelve a crear”.
- Honestidad con los números. Mostramos también lo que todavía no es bueno, como el 55 % en segmentación, y explicamos por qué.
Qué aprendí #
Los modelos de decisión cambian cómo se diseña con IA. En vez de pedirle a un modelo de lenguaje que “opine” y luego interpretar su texto, le haces preguntas pequeñas y tipadas, y el código decide con reglas claras. Es más rápido, medible y fácil de auditar.
Separar decidir de escribir. JEV decide; el modelo de lenguaje solo escribe cuando hace falta; la persona revisa lo que importa.
Calibrar con datos etiquetados. Pasar del 53 % al 80–87 % de acierto no fue cambiar de modelo: fue ajustar las preguntas y los umbrales con ejemplos.
Los agentes de IA aceleran muchísimo, pero el criterio de producto, las decisiones y la verificación siguen siendo del humano.
El mismo motor sirve para la siguiente decisión: quién está por abandonar un programa, o si la respuesta de un agente de IA puede salir al cliente. Es otro set de preguntas, no otro sistema.
Enlaces #
- Demo
- Pitch
- Playbook
- Código abierto en GitHub (AGPL-3.0)
Equipo DevGain: Michael Liendo (producto, arquitectura, backend, IA y despliegue) y Haron Acosta (fullstack: la landing, la pantalla de ingreso e ideas iniciales).
¿Tu equipo revisa contenido a mano? #
Si en tu empresa alguien pasa el día aprobando piezas una por una, hablemos. Escríbeme por WhatsApp y cuéntame cómo lo hacen hoy.